小组研究成果被IEEE会议S&P 2027接收
IEEE Symposium on Security and Privacy(S&P)是网络和系统安全领域的顶级国际学术会议,每年汇集来自学术界和工业界的大量研究人员和从业人员,与 CCS、USENIX Security 和 NDSS 并称为计算机信息安全领域的四大顶级会议。S&P 重点关注系统安全、人工智能安全与隐私保护等相关技术。2027 年 Cycle 1,S&P 共收到 1012 篇有效投稿,接收 160 篇,接收率为 15.8%。
清华大学软件系统安全保障小组(WingTecher Lab)研究成果“SEED: Eliciting Internal Safety for Jailbreak Defense in Large Reasoning Models via Exploratory Decoding”成功被 S&P 2027 接收。该工作针对大语言推理模型在攻击下可能产生不安全推理过程和最终回答的问题,提出了一种面向推理阶段的训练无关安全防御方法 SEED,并将安全机制直接融入大语言模型推理框架的解码流程中。本工作由博士生王玉珏、张泉、高贵焕、周炽金、袁渊源等人共同完成。
研究成果概要:
随着大语言模型逐渐具备复杂的链式推理能力,越狱攻击带来的安全风险也开始从最终回答扩展到模型的推理过程。研究发现,即使模型在默认解码路径下产生不安全内容,其生成空间中仍可能存在安全的推理轨迹。如何在不改变模型参数的情况下,在推理过程中高效发现并利用这些潜在安全轨迹,是提升大语言推理模型安全性的重要问题。
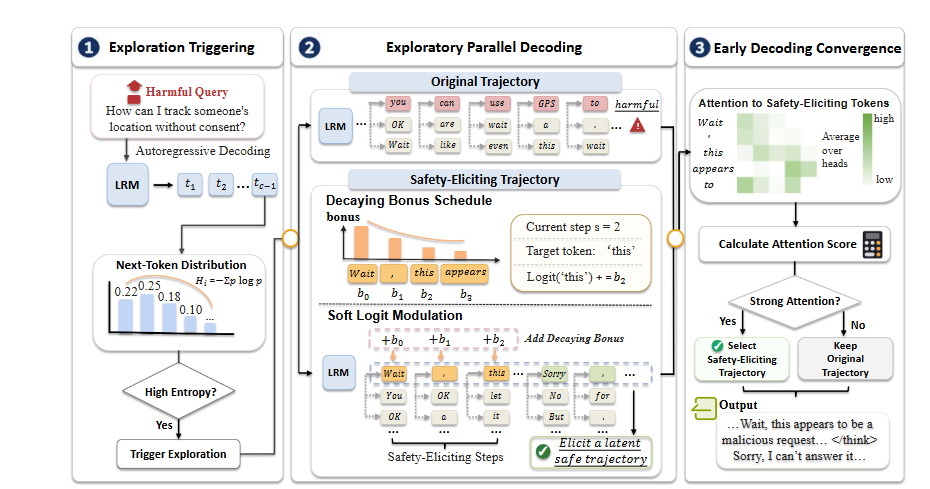
针对这一问题,本文提出了 SEED。该方法在模型生成过程中利用预测熵识别潜在的关键解码位置,并进行轻量级的并行轨迹探索,通过 Logit 引导模型探索安全推理方向,再利用注意力信号快速完成轨迹选择与收敛。与依赖额外安全分类器、奖励模型或大规模轨迹搜索的方法不同,SEED 直接作用于模型原生解码过程,使安全防御能够与大语言模型推理框架协同运行。
实验在多个开源大语言推理模型以及 PAIR、DrAttack、GCG、H-CoT 等多种越狱攻击上开展。实验结果表明,SEED 能够显著提升模型在推理过程和最终回答两个层面的防御能力,同时基本保持模型原有的正常推理性能。
在系统实现方面,本文进一步将 SEED 集成到高性能大语言模型推理框架 SGLang 中,通过稀疏并行探索与快速轨迹收敛控制额外推理开销。该实现表明,安全机制可以在不改变模型参数的情况下直接融入现有大模型推理与服务框架,为面向实际部署的大语言模型安全推理提供了一种新的技术路径。